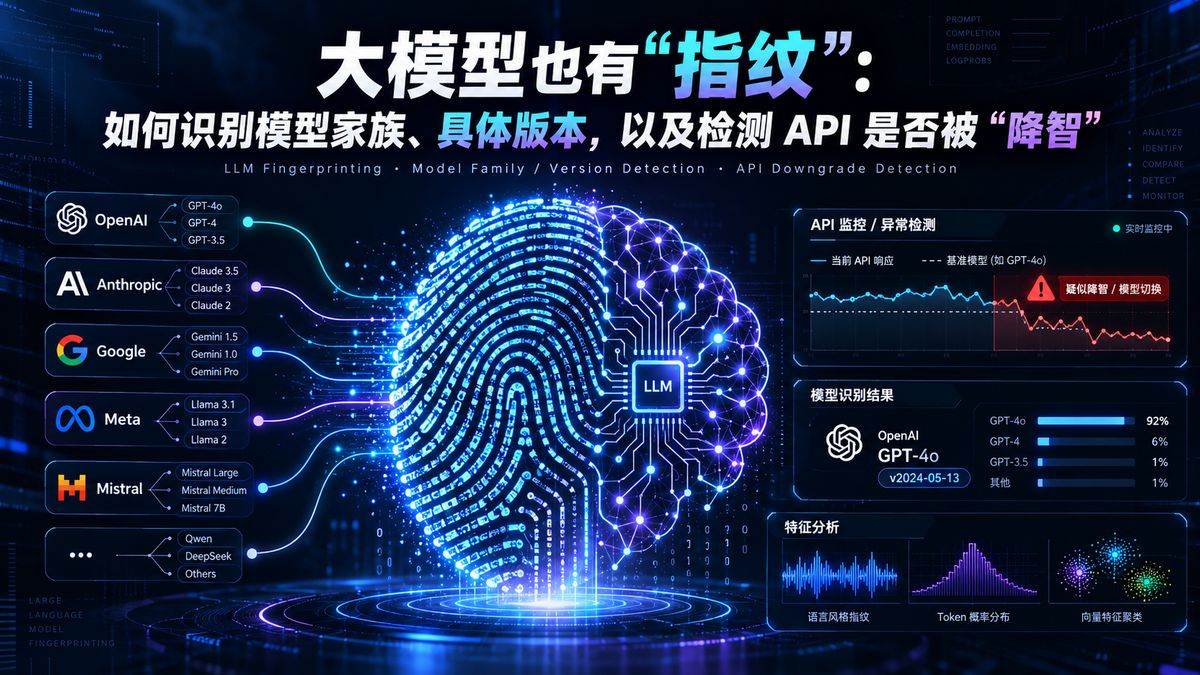
相信使用过中转站的人,都会对中转站形形色色的各种套路有所体会,最常见的套路主要包括:
- 黑盒API的“挂羊头卖狗肉”:你调用的是宣称 $Claude-3.5-Sonnet$ 的中转接口,背后真的是 Sonnet 吗?还是被盗版商悄悄替换成了更便宜的开源小模型?
- 模型的“暗降与降智”:大模型在遭遇高并发、系统 Prompt 干预或服务端策略微调时,可能出现思维链断裂、推理能力骤降(即“降智”)。
为了解决以上问题,各种针对大模型的特征识别的技术不断涌现。
API 返回体里的 model 字段,几乎是整条调用链里最不可信的一个字符串。中转站可以按旗舰价计费、后台把请求路由到更便宜的模型;官方产品也可以在额度耗尽、风控触发或滚动发布时,把同一对话静默切到 mini、更弱的推理档,或内部别名。界面上仍写着你选的那个名字。
最常见的检测手段是 LLM Fingerprinting 大语言模型指纹识别。
LLM Fingerprinting 不依赖服务商告诉你模型是什么,而是尝试通过模型输出中难以完全隐藏的统计和行为特征,反推出它属于哪个模型家族,甚至进一步识别具体版本。
这套技术经常被用于检测第三方 API、中转服务甚至 Agent 服务有没有发生模型替换,也就是通常所说的“降智”。
于是出现两类彼此相关、方法却不完全相同的问题:
- 特征指纹检测:这个黑盒到底是哪个模型家族、更接近哪个具体版本?
- 降智检测:名义上还是那个模型,但能力、推理强度、上下文或路由策略是不是被悄悄削弱了?
前者回答「你是谁」;后者回答「你是不是变弱了」。社区里把两者统称「验真 / 降智检测」,但原理应当分开讲。
相关技术原理剖析
1. 大模型特征指纹识别(Model Fingerprinting)
特征指纹技术的目标是:通过少量的探针输入(Probing Inputs),利用模型的输出行为特征,精准判定其底层具体的模型家族与模型版本。
主要实现原理分为以下三种层级:
A. 概率分布与 Logits 层面(白盒/半黑盒)
若 API 返回了候选词的概率分布(Logits 或 Logprobs),不同模型因为词表(Tokenizer)、训练数据集及采样算法(Top-p/Top-k/Temperature)的差异,对同一 Prompt 产生的词分布轨迹是独一无二的。这种“语义流转轨迹”就构成了模型的固有生物特征。
B. 文本特征与格式印记(纯黑盒)
当 API 仅返回纯文本(无 Logits)时,指纹识别依赖于模型在系统层面和训练数据中的“习惯印记”:
Tokenizer 与特殊 Token 泄漏:不同模型的系统标记词不同,例如 <|im_start|>、<|endoftext|>、<s> 等。设计特定的边界探针可以诱导模型吐出这些标志词。
对特定标点/格式的处理:如 OpenAI 家族、Anthropic 家族、DeepSeek 家族在处理 Markdown 表格、JSON 规范、Markdown 代码块结尾标记(如是否加换行符)上有极其固定的模式。
特定拒答与偏见回复模式:对于敏感问题或界限模糊的问题,不同厂商的 RLHF(强化学习人类反馈)策略对拒答措辞(”I am an AI created by…”)有强烈的固定表达。
C. 系统提示词(System Prompt)与陷阱测试
使用专门设计的探针(Probing Prompts),例如:
边界越狱测试:利用特制的逆向指令测出模型的底层保护机制。
数学与逻辑盲区测试:不同模型在特定难题(如 9.11 与 9.8 的大小比较、strawberry 中有几个 r)上的独特倾向和思维链轨迹。
2. 降智与性能衰退检测(Degradation Detection)
“降智”通常指的是 LLM 在遇到某种上下文干预、长文本压力、服务端资源限制或路由降级(如 Sonnet 被路由到 Haiku,或思维链推理模型如 DeepSeek-R1 丢失了 <think> 过程)时,表现出的能力下降。
降智检测的核心判定指标包括:思维链(CoT),Tokenizer 截断与重构,信息熵/困惑度(Perplexity)衰退,拒答率与模式漂移。
思维链(CoT)完整性检测:探针发送复杂的多步逻辑推导题,观察模型是否直接给出结论而跳过了长推理过程(如是否缺少深度思考上下文)。
Tokenizer 截断与重构:高并发下服务器为了节省算力,可能会对用户 Context 进行强行截断,通过检测模型对上下文长距离依赖信息的提取准确率,可量化降智程度。
信息熵/困惑度(Perplexity)衰退:降智的模型在回答复杂问题时,通常会倾向于使用高频词、通话套话,整体输出的信息熵会显著降低。
拒答率与模式漂移:系统过于敏感或模型受限时,安全机制可能被误触发,表现为频繁抛出泛化的安全拒答模板。
常见开源工具
ModelTrace
https://github.com/xqy2006/ModelTrace
本地运行的主动模型归因工具,用三个“随机数字挑战”识别模型,通过三条独立的长整数生成挑战 → 抽指纹 → 在统一候选库里给出家族和具体版本。
LM Fingerpoint Detector
https://github.com/Ikaleio/lm-detector
基于 ModelTrace 的模型指纹检测器,Web 与 CLI 共用算法和正式数据库。把「三条整数挑战比分布」做成可部署产品,并补上了排序器、验证器和校准。
hlwy-ai-checker
https://github.com/hanlinwenyuan/hlwy-ai-checker
检查第三方 AI API 是否掺假以及渠道一致性。
ModelTrace 更适合用于检测这个未知模型是谁?hlwy-ai-checker 更适合用于检测这个第三方 API 与我手里的官方 API 行为是否一致?
因此特别适合“降智检测”。
Model Check Core (model-check)
https://github.com/dufeisolo/model-check-core
极速、轻量、专业的大模型 API 中转站检测工具(LLM API Inspector),针对模型替换、模型掺水、模型降智等场景,确保买到真实的大模型API。
is-gpt-nerfed
https://github.com/kiyoakii/is-gpt-nerfed
Codex 日志 + 随机数指纹,盯静默换模 / 降档
LLM Fingerprinting System
https://github.com/litemars/LLM-Fingerprinter
多层行为探针 + 集成分类,家族 / 版本 / unknown
API CHECK
https://github.com/october-coder/api-check
lm-evaluation-harness
https://github.com/EleutherAI/lm-evaluation-harness
能力评测底座,配合统计检验做真·降智
LLMmap
https://arxiv.org/abs/2407.15847
主动探针指纹的代表性论文