在当今 AI 深度融入日常生活与学术研究的时代,无论是学术论文、技术文档还是日常代码,许多写作者都曾面临过一个痛点:AI 辅助生成的文本或代码,经常会被 Turnitin、iThenticate、GPTZero、Copyleaks 等各种查重与 AI 检测工具误判或拦截。
于是各种号称能“去 AI 味(AI Humanizer)”的工具也迅速流行起来,这些工具通常会把 AI 生成的文章通过调整句式、词汇、语气和文本节奏,让文章读起来更自然,并尽可能降低 AI 检测工具给出的概率。但这些工具一般按字数收费、存在数据和隐私泄露风险。
针对 AI 生成文的特征,维基百科有专门词条 https://en.wikipedia.org/wiki/Wikipedia:Signs_of_AI_writing ,也是众多 AI Humanizer 工具的理论基础。
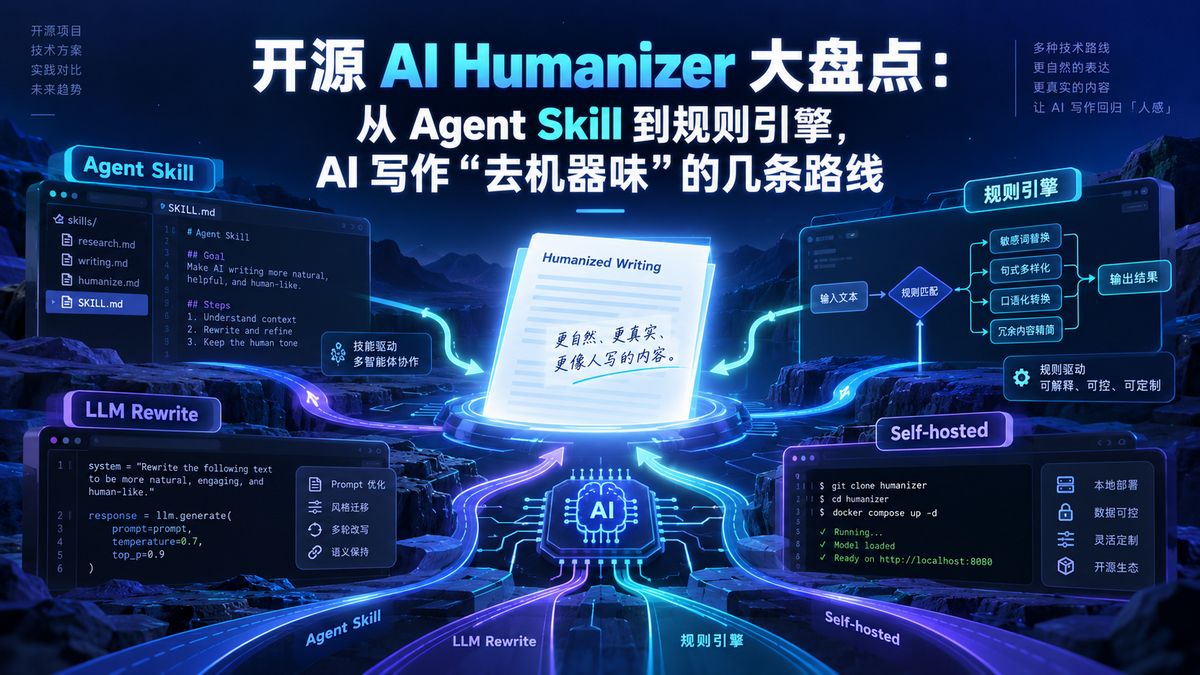
汇总一下开源的优秀 AI Humanizer 项目。
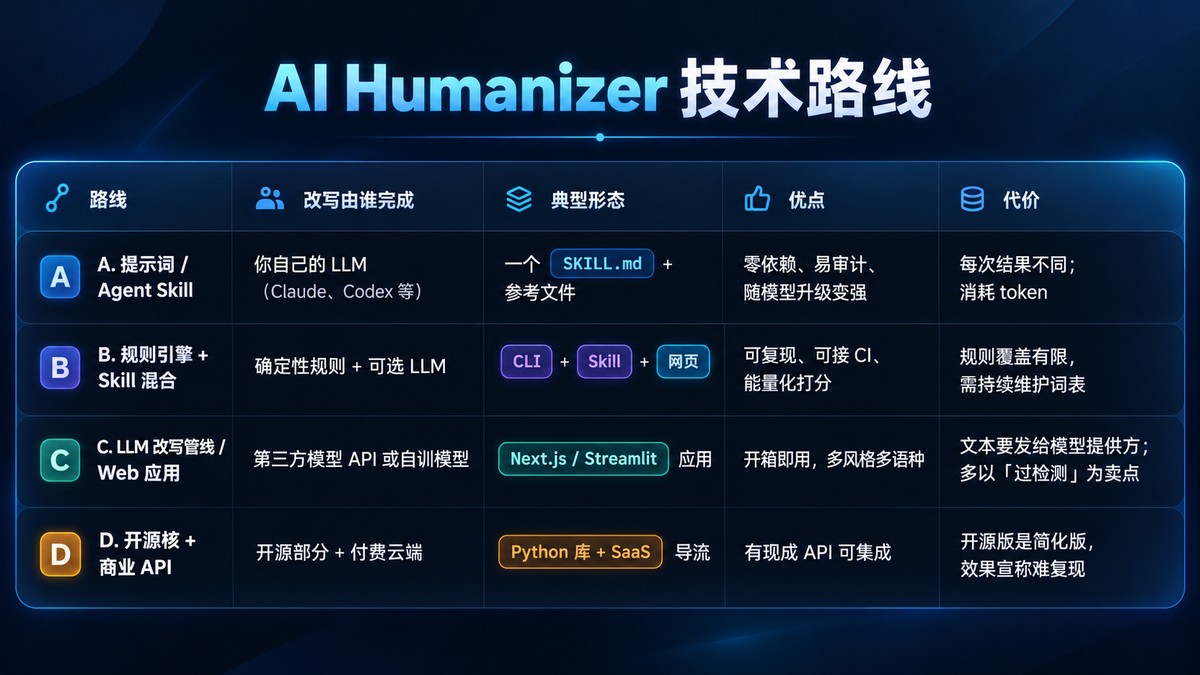
AI Humanizer 按技术路线可分四类:提示词 / Agent Skill,规则引擎 + Skill 混合,LLM 改写管线,开源核 + 商业 API。
A. Agent Skill
blader/humanizer
https://github.com/blader/humanizer
当前最有影响力的开源 Humanizer,英文首选。基于维基百科 WikiProject AI Cleanup 维护的《Signs of AI writing》,覆盖 26 个左右核心模式(“Not X but Y”、单句结尾、堆砌排比、过度破折号、空洞升华句等)。支持提供自己的写作样本做语气匹配,改写前会标出问题位置。明确声明目标是给人类读者看,而非保证绕过检测器。安装后以 /humanizer 触发,支持 Claude Code、Codex 及 Skills CLI 覆盖的多数代理。
op7418/Humanizer-zh
https://github.com/op7418/humanizer-zh
归藏翻译的 blader 中文版,针对中文 AI 写作常见问题(模板腔、空话、过度排比、“首先其次最后”、翻译腔、四字堆砌等)做了本地化。保留事实与作者声音,适合博客、周报、邮件、学术草稿润色。
类似的项目还有:https://github.com/zeddyu/humanizer_zh
Aboudjem/humanizer-skill
https://github.com/Aboudjem/humanizer-skill
提供 55 个模式目录、5 种语气预设、0-100 AI-tell 评分,并有可选的本地 CLI 做确定性指标计算(爆发性、词汇多样性等)。强调完全本地、不调用外部检测器。适合需要量化反馈或在 CI 中做门禁的用户。与 blader 版本互补,可同时安装按场景调用。
petergyang/no-ai-slop
https://github.com/petergyang/no-ai-slop
专注清除社交媒体与博客常见的 AI 套话(二元对比、假深刻开场、空洞洞察等),支持“只检测不改写”模式,并会列出修改内容。更偏向个人创作者保留原有语气,适合公众号、X/推文、短内容
hardikpandya/stop-slop
https://github.com/hardikpandya/stop-slop
更激进的「写作约束」而非「事后改写」。禁用套话开场、强调拐杖词、所有副词、破折号和 Wh- 开头句,并给出直接性、节奏、信任、真实感、密度五维 1–10 打分,低于 35/50 就重写。适合放进系统提示词,让模型一开始就少写废话。
B. 规则引擎 + Skill 混合
devswha/patina
https://github.com/devswha/patina
工程化程度最高的一个,支持韩、英、中、日四种语言,189 个命名模式,每处改动可用 –diff 追溯原因。
swaylq/humanize-chinese
https://github.com/swaylq/humanize-chinese
零依赖、零 LLM、纯 Python 标准库的中文方案。检测端融合规则特征、字符级 n-gram 困惑度、GLTR 分桶和句长突发度,阈值在 HC3-Chinese 数据集上校准;改写端有词表替换、句长调整和八种中文文体风格转换。另带零宽字符和康熙部首同形字检查与清理。带有一个面向知网/维普的「学术降 AIGC」模式,开发者写明不保证过检,且不该用来规避学术诚信审查。
C. LLM 改写管线
rudra496/StealthHumanizer
https://github.com/rudra496/StealthHumanizer
支持 35 家模型提供方(含 Ollama、LM Studio、vLLM 本地后端,以及调用已登录的 Claude Code / Codex CLI),四档改写强度、多种文体和语气,另有 CLI 和浏览器扩展。v3 起短文本改用自己微调的 BART 模型,并采用「采样 8 个候选取检测分最低」的策略。工程扎实,但项目描述直接以绕过 GPTZero、Turnitin 为卖点并面向学生,这一点读者需要自己掂量。
D. 开源核 + 商业 API
lynote-ai/humanize-text
https://github.com/lynote-ai/humanize-text
注重文本结构与语义完整度的开源重写 Pipeline。核心思路:不断跨越语言结构,让原始 AI 文本的句法和统计特征被重新构造。其中前两次使用 LLM 高 Temperature 重写,后两步使用不同 NMT 翻译引擎。
适合需要批量处理多语言(支持中、英、法、西等)学术摘要、技术文档或长文章的场景。
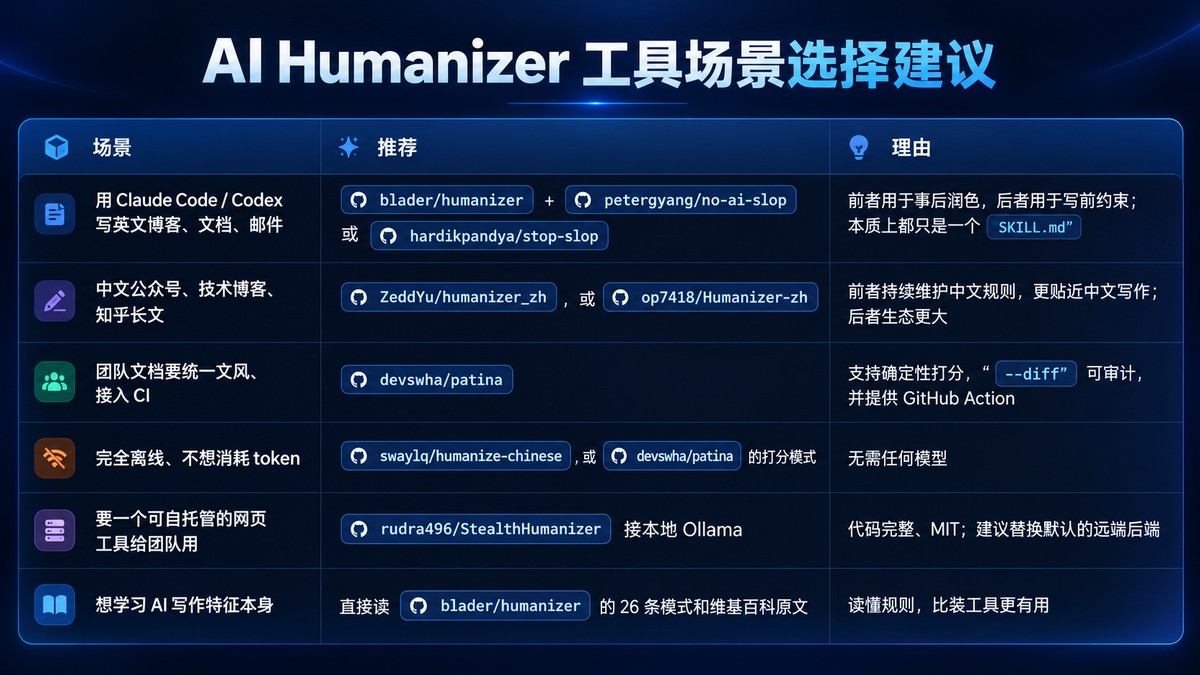
AI Humanizer 工具场景选择建议