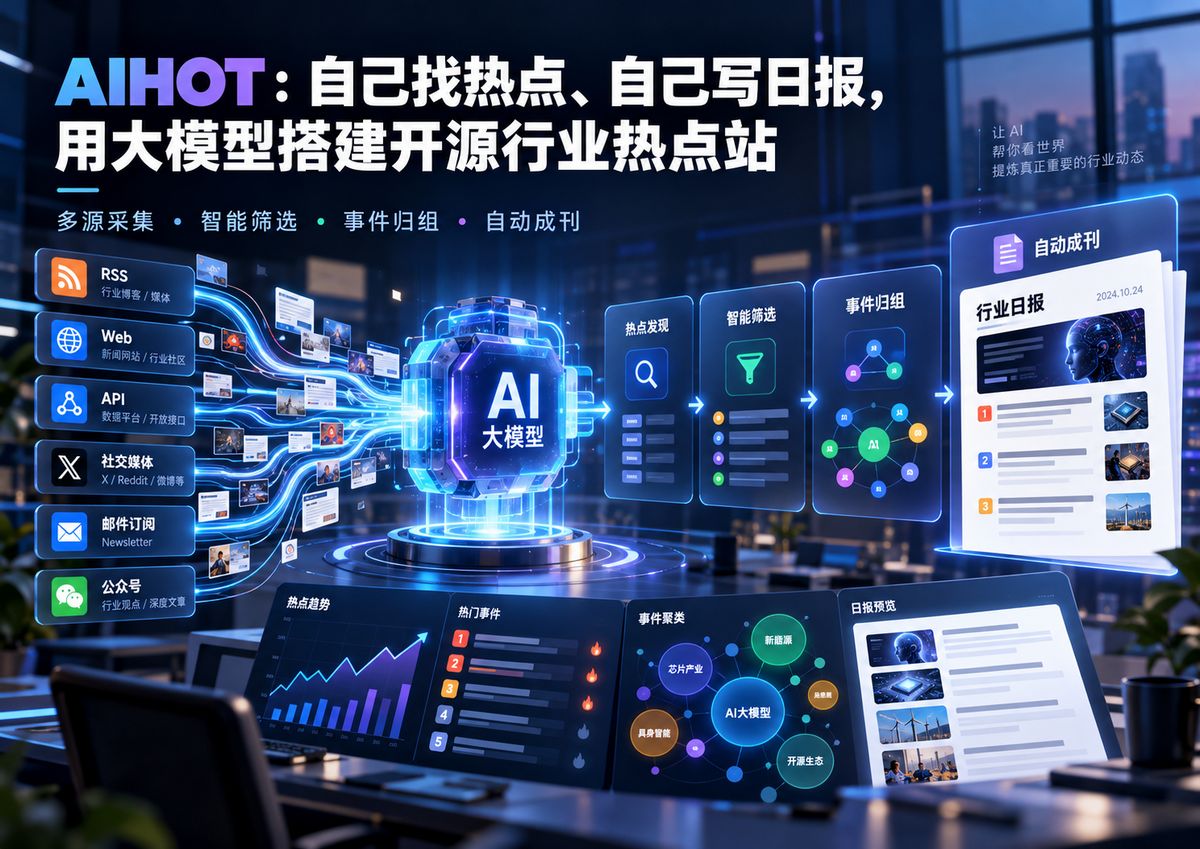
在信息爆炸的当下,几乎每个领域的从业者都面临同样的难题:信源分散、垃圾资讯泛滥、高价值热点容易遗漏。
每天打开 X、微博、Hacker News、GitHub、Reddit 等资讯源,很快就会遇到一个问题:资讯不是太少,而是太多。
真正困难的已经不是“找到新闻”,而是从成百上千条更新中判断:
- 哪些事情真的重要?
- 哪些只是同一条新闻被几十家媒体重复转发?
- 哪些是营销稿?
- 哪些事情突然开始被大量不同来源讨论?
- 哪些值得今天花时间看?
- 最后,能不能自动整理成一份日报?
由 数字生命卡兹克(@Khazix0918)开发的 AIHOT( https://aihot.news ) 就是为了解决这个问题,并且已经运行了半年多,相信很多人科技从业者已经在使用。
2026 年 9 月 29 日,数字生命卡兹克 在 X 上发帖宣布:把已经做到约百万月活的 AI 热点站 AIHOT 正式开源。采集、精选、聚簇、生产环境里的全部 Prompt——能开的都开了。
GitHub:https://github.com/KKKKhazix/AIHOT
AIHOT 最初是 数字生命卡兹克 公司内部用来盯选题的飞书机器人。没有站点,没有品牌,只是把一堆信源里「今天该看什么」压成内部消息。后来才长出网页、日报、Skill、API、MCP,再换成好记的域名 aihot.news。作者自己的说法是:从年前靠 AI 做出第一版,到开源,大约七八个月。
AIHOT自动化流水线核心步骤
AIHOT 的核心不是简单地把资讯抓回来,而是建立了一条从采集、筛选、评分,到事件归组和自动成刊的完整处理流水线。涉及大模型判断与写作的 Prompt 基本都集中在 `industry/prompts/` 下,因此要把它改造成法律、金融、SaaS 等其他行业的热点站,通常只需要调整信源、Prompt 和入选门槛,而不用重写核心代码。
具体可以拆成下面几个环节:
- 采集:支持 RSS、网页列表、JSON API、X 账号、微信公众号,以及外部脚本主动推送六类信源。不同信源还可以设置等级、参与模式和抓取频率。
- 判重与预筛(`prefilter.md`):新资料进入系统后先进行判重,再由模型做宽松的相关性预筛,主要过滤明显与目标行业无关的内容,避免把大量无效信息送入后续较昂贵的评分流程。
- 两轮独立评分(`selection-score.md`):通过同一套行业评分标准,让模型对候选内容独立评分两次。评分体系包含内容类型、五个评价维度及不同类型的权重,同时定义哪些内容应正常评价、哪些噪声需要压低。最终根据两次评分结果以及信源等级对应的门槛决定是否进入精选;默认门槛为 T1 60、T1.5 65、T2 76,换行业后官方建议用自己标注的样本重新校准。
- 内容理解与写作(`content-understanding.md`、`summarize-*.md`):对于入选内容,模型生成中文标题、答案先行的摘要、推荐理由和标签;其他内容则使用较轻量的摘要流程处理。系统还专门加入限制,避免模型把原文没有出现的公司或机构擅自写进标题。
- 结构化抽取(`structure.md`):进一步提取分类、标签、主体公司/机构以及关键事实关系,为主题页、检索、事件归组等后续功能提供结构化数据。这一环节并不是简单的“再写一次摘要”,而是把自然语言资讯转换为机器更容易利用的数据。
- 事件归组(`group-*.md`、`story-digest.md`):系统先利用标题和摘要的向量,在最近两周内容中寻找可能属于同一事件的候选,再让模型判断它们究竟是同一事件、后续进展,还是完全不同的事情;不确定的合并还可以换另一模型再次确认。不同来源报道的同一件事最终会被聚成一个 Event,并生成事件综述。
- 热点与成刊(`report-*.md`):热点不是按照文章数量,而是按照事件计算:48 小时窗口内,每个独立来源只贡献一次热度,并按 24 小时半衰期衰减,从而避免一家媒体连续发布多篇文章人为放大热度。最终这些事件再进入日报、周报和月报。官方 README 明确给出的发布时间是:日报每天 08:00、周报每周一、月报每月 1 日。
AIHOT 精选机制:双评分 + 分级门槛
入选规则是「两次评分之和 ≥ 2 × 门槛」,页面显示两次的平均分(向下取整)。独立评两次的意义在于压低单次采样的随机性,这是 LLM-as-judge 里最便宜的降噪手段。门槛按信源分级设置,写在 industry/selection.ts 。
校准流程是项目最有方法论价值的部分:
1. 从自己的信源里挑 100–200 条,逐条标注 select / reject / either,存成 .data/gold.jsonl;建议多放贴着边界的难例,并切出一部分做留出集(holdout)。
2. 用 scripts/eval-selection.ts 跑评测,输出准确率、查准率、查全率,以及门槛从 40 到 90、每隔 2 分的扫描结果;–models 可在同一批样本上比较多个模型。
3. 在后台 SelectBench 里逐条看判错的条目和模型理由,先改评分标准,最后才动门槛——门槛只能整体平移,解决不了「哪一类判错」。
这套流程本质上就是把提示词当成可回归测试的代码来维护。评测调用带回执复用,重跑未改动的部分不会重复花钱。
AIHOT 聚簇与热度:按事件计,不按文章计
热榜的单位是「事件」。官网发一篇、媒体转十篇、X 上讨论一天,在读者面前只出现一次。
• 候选召回:用标题摘要的向量在最近两周里找相似条目。
• 判定:模型判断是「同一件事」「后续进展」还是「两件事」;拿不准的换一家模型复核。后续进展挂在同一事件下,人工改过的归属不会被覆盖。
• 热度:48 小时窗口内,每个独立来源只计一次,24 小时衰减一半;一家媒体发十篇也只算一次。与 6 小时前对比,涨得快的标「上升」,新出现的标「新」。
• 旧文不刷屏:发现时已发布超过 48 小时的资料、新信源的存量,按原文时间归档,不进「今天」。
「独立来源数」比「文章数」更难被刷,但它的前提是信源列表本身分布均匀。如果你的信源里有一半是同一圈子的 X 账号,热度反映的就是这个圈子的注意力。
如何将它改成你自己的“行业热点站”?
AIHOT 在架构设计上实现了代码与业务 Know-How 的解耦。更改行业属性时,几乎不需要改动核心框架代码,主要修改集中在 industry/ 目录下。
极简改装建议(配合 AI Agent)
开发者可以直接搭配 Claude Code、Codex 等 Agent 工具,直接对 AIHOT 提问并改装:
Prompt 示例:
请阅读 AGENTS.md 和 docs/customize.md,把这个站改造成『新能源汽车』行业的热点站。我关心的信源有 [信源列表],我认为重要的消息类型是 [标准描述]。
需要定制的核心文件列表如下:
- industry/site.ts:站名、Logo、首页标语及关于页配置。
- industry/sources.json:配置你所在行业的权威一手信源与高质量媒体。
- industry/taxonomy.ts & topics.json:定义行业分类、主题词与标签体系。
- industry/prompts/:核心资产。修改 selection-score.md,用你所在领域的评估标准来教模型“什么才是真正的行业大新闻”。
AIHOT 的出现,代表了 “AI + 垂直信息流” 落地的一个典范。它不仅是一个开箱即用的前端+后端组合,更提供了一套验证过的、包含降噪与聚簇功能的完整数据管道架构。
如果你的团队正消耗大量人力在盯盘、做日报、写行业周报,或者你想在自己的垂直领域做一个优质的信息聚合站,AIHOT 是一个非常值得尝试与二次开发的开源项目。