相信很多职场人士都遇到过这样的场景:明明记得保存过某份文件,也依稀记得里面出现过某段错误日志、某张发票的信息,甚至只记得截图中的几个关键文字,却偏偏想不起文件名。于是在电脑里翻目录、试关键词,折腾半天还是找不到。
面对这种“记得内容,却忘了文件名”的情况,Everything、Listary、Cardinal、FSearch 这类以文件名检索见长的工具很难发挥作用;macOS Spotlight、Windows Search、Recoll、AnyTXT、DocFetcher 等全文搜索工具虽然可以进一步检索文档内容,但通常需要预先解析文件并建立全文索引,而要搜索图片和截图中的文字,还需要额外的 OCR 能力。
AI 时代兴起的 RAG 和语义搜索进一步解决了“连原文关键词都记不清,只记得大概意思”的问题,但代价往往是引入另一套复杂的技术栈:文档切片、Embedding 模型、向量数据库,部分方案还需要较高的 CPU、内存甚至 GPU 资源。对于只是想在自己的电脑里快速找回一份文件的普通用户来说,未免有些重了。
Kensaku(日语「検索」,意为“搜索”)正是针对这个场景而生的开源项目。
Kensaku:https://github.com/yjid/kensaku
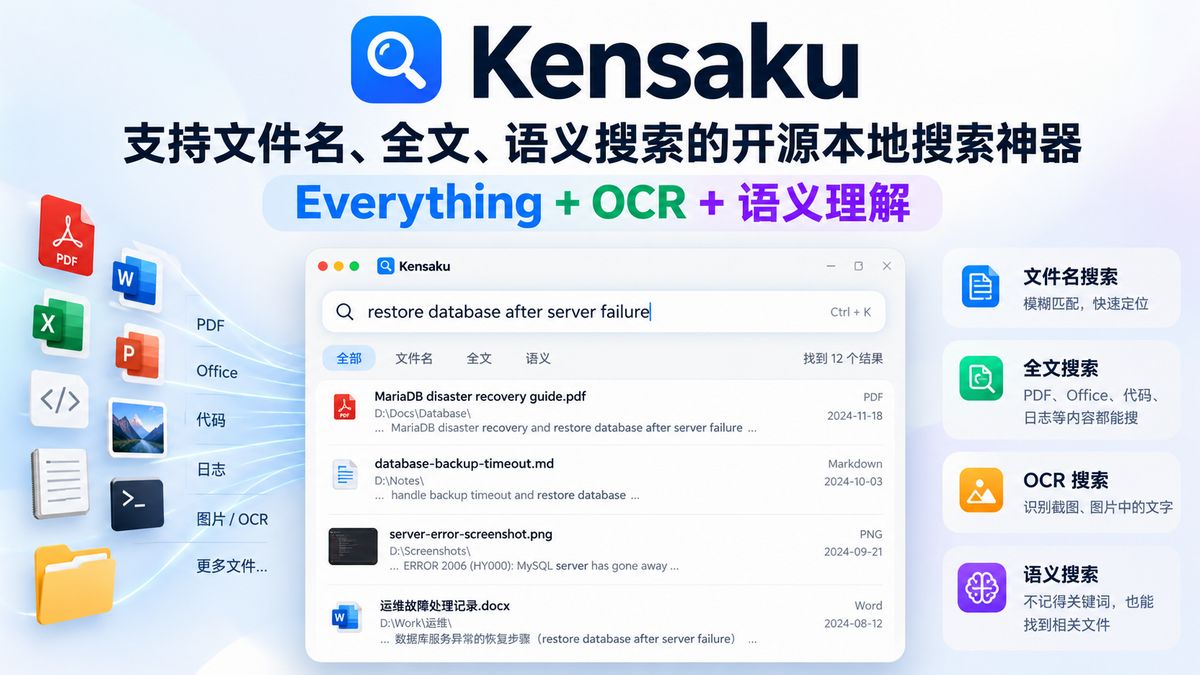
Kensaku 是一个开源、本地优先的桌面搜索工具,可以同时搜索文件名、PDF 和 Office 文档内容、代码、日志,还能通过 OCR 搜索图片里的文字。更特别的是,它加入了轻量级语义搜索,却不需要为了每次查询运行一个庞大的 Transformer Embedding 模型。
Kensaku 的主要功能包括:
- 极速文件名搜索:约 10 万文件的内存索引下,单次键入响应约 1.3–2.8 ms,索引内存占用约 12 MB。
- 文档全文检索:支持 PDF、DOCX、PPTX、XLSX、EPUB、ODT、RTF、代码和日志等,并支持 CJK 文本。
- OCR 图片搜索:默认使用 Tesseract,并可选 PP-OCRv6,可以直接检索截图、扫描件中的文字。
- 语义与自然语言搜索:除了关键词,还能根据内容含义寻找文件,并支持“上周的截图”这类自然语言查询。
- 高级查询语法:支持
type:pdf invoice、modified:7d、lang:rust、size:>10mb以及正则表达式等过滤条件。 - 桌面启动器体验:支持托盘常驻、全局快捷键、实时结果、键盘导航、预览以及列表/网格视图。
- MCP 与本地 AI:可以连接 Ollama、LM Studio,也可以通过 MCP 将本地搜索能力提供给 Claude、Cursor 等 AI 客户端。
- 本地优先与隐私保护:索引保存在本机,默认排除隐藏文件、构建目录以及
.pem、.key等敏感文件。
三条检索路线:文件名、全文与语义搜索一起跑
Kensaku 最值得关注的地方,是它没有把所有搜索任务都交给 AI,而是采用了一套轻量的混合检索架构:
文件名模糊搜索(Filename Fuzzy Search)+ BM25 全文搜索 + Semantic Search,再通过 RRF 将三路结果融合。
首先,Kensaku 会解析 PDF、DOCX、PPTX、XLSX、EPUB、RTF、代码和日志等文件,将文字提取出来建立索引;图片和截图则可以借助 Tesseract 或 PP-OCRv6 识别文字。因此,它搜索的不只是“文件叫什么”,还包括“文件里面写了什么”。
三条检索路线分别解决不同的问题:
- 文件名模糊搜索:适合还记得部分文件名,或者拼写不完整、不准确的情况。
- BM25 全文搜索:适合准确关键词、错误码、型号、函数名等检索。例如
MariaDB backup timeout、CVE-2026-109619,传统全文搜索往往更加可靠。 - Semantic Search:适合已经忘记原文,只记得内容大概讲什么的情况。
其中最特别的是 Semantic Search。
常见语义搜索通常需要 BGE、E5、Nomic 等 Embedding 模型生成向量,再配合向量检索系统;Kensaku 默认使用的却是一个只有约 7.7MB 的静态量化 Embedding Table,以非常轻量的方式计算语义相关性,不需要每次查询都运行大型 Transformer Embedding 模型,也不要求 GPU。
例如用户搜索:
restore database after server failure
而某份文档使用的其实是:
MariaDB disaster recovery
即使两边没有完全相同的关键词,Semantic Search 仍有机会根据语义关联找到它。
这也是 Kensaku 的设计思路:该精确匹配时使用传统搜索,需要理解意思时再使用 Semantic Search,而不是用 AI 取代所有搜索。
但随之又出现一个问题:文件名匹配、BM25 和语义搜索使用完全不同的评分体系,三个结果应该怎样合并?
Kensaku 的答案是 RRF(Reciprocal Rank Fusion)。
可以把它简单理解为一种“综合排名”机制:它不太在意每种搜索方式具体打了多少分,而更关注同一个文件分别在不同搜索结果中排在什么位置。
比如一份文档在文件名搜索中排名一般,却同时在全文和语义搜索中名列前茅,那么它很可能确实与当前查询高度相关,最终排名就会得到提升。反过来,如果某个文件只被一种搜索方式认为相关,另外两种几乎都不认可,它通常不会排得太靠前。
这样一来,Kensaku 不必在“精确关键词”和“理解语义”之间二选一,而是让三种检索方式互相补充,最终把最可能是用户真正想找的文件排到前面。
从自然语言搜索到 AI Agent
除了传统关键词和语义搜索,Kensaku 还支持直接用自然语言描述文件。例如输入 screenshots from last week,它可以识别“截图”和“最近一周”这两个条件,并转换成相应的文件类型与时间过滤。这个过程本身并不依赖 LLM,而是通过本地规则完成,因此无需为了简单查询调用大模型。
如果希望进一步使用 AI,Kensaku 还可以连接 Ollama、LM Studio 等本地模型,用于 Query Refinement 和 /ask 问答。简单来说,Kensaku 负责从本地文件中找资料,LLM 负责阅读和回答,从而组成一套轻量的本地 RAG。
它同时提供 MCP Server,可以把已经建立好的本地检索能力交给支持 MCP 的 AI 客户端。这样 AI Agent 不必重新扫描硬盘、解析 PDF、建立另一套搜索索引,而可以直接通过 Kensaku 查询本地的 PDF、Office 文档、代码、笔记和日志。
因此,Kensaku 不只是一个桌面搜索框,也可以充当 AI Agent 与本地文件之间的检索层:平时由用户直接搜索,需要 AI 时,再把同一套本地索引提供给模型或 Agent 使用。
写在最后
Kensaku 最有意思的地方,并不是简单给文件搜索加上 AI,而是把不同技术放在各自擅长的位置:文件名交给模糊匹配,精确内容交给 BM25,只记得大概意思时再使用语义搜索,最后通过 RRF 综合排序。
相比 Everything,它更擅长解决“记得内容却忘了文件名”的问题;相比完整的 RAG 知识库,它又更加轻量,不需要为了搜索本地文件就部署一整套 Embedding 模型和向量数据库。
因此,Kensaku 更像是填补了传统桌面搜索与本地 RAG 之间的空白:既能帮人找回散落在电脑里的文档、代码和截图,也能通过 MCP 把同一套本地检索能力提供给 AI Agent。