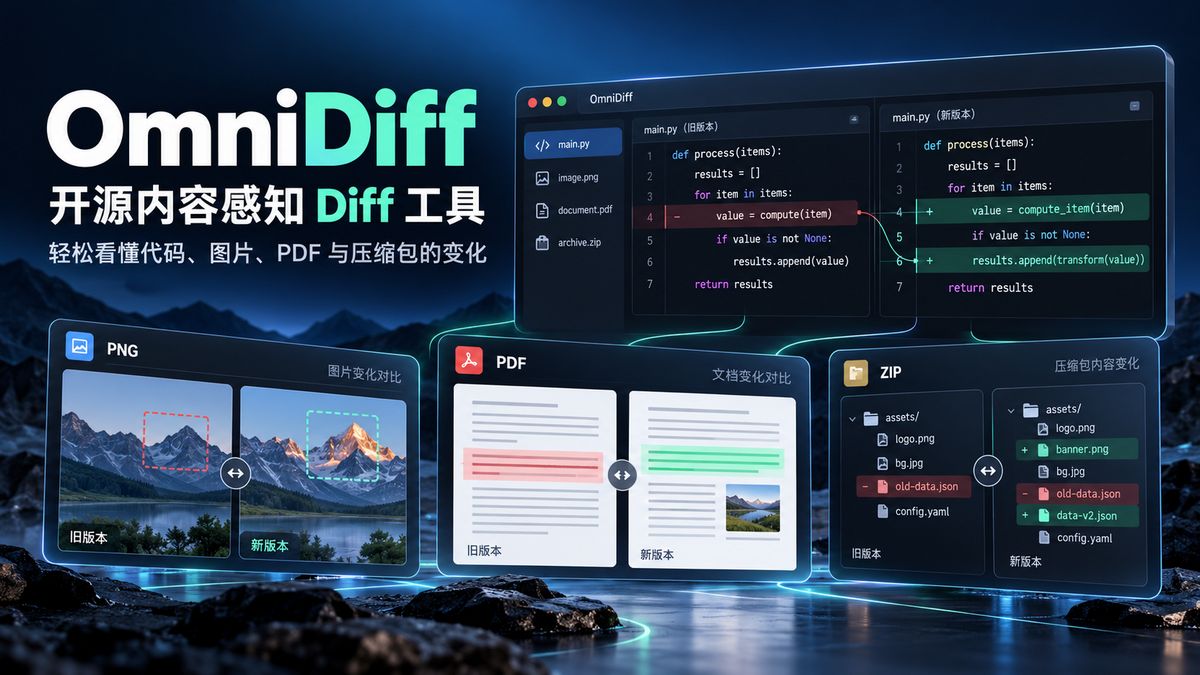
在日常工作中,比对多版本文件的差异是高频刚需。尽管市场上已有 git diff、Unix diff、WinMerge、Beyond Compare 及 diffoscope 等经典工具,覆盖了文本、图片乃至压缩包和 PDF 的比对场景,但它们大多受限于“逐行比对”的底层机制。
逐行比对的最大痛点在于:视觉呈现往往会过度放大实际的修改成本。例如,仅仅修改了等号右侧的局部表达式,却会触发整行删除与新增的标红;将一段核心代码整体迁移,也会被粗暴地拆解为两处毫无关联的增删。尤其在经过代码格式化工具的缩进调整或重新换行后,满屏的红绿交错极易沦为视觉“噪声”,导致真正值得关注的逻辑变动被彻底淹没。即便部分工具提供了行内高亮或移动检测功能,依然难以直观呈现代码结构之间的真实演化关系。
针对“逐行比对”的问题,目前主流解决方案是引入“语法感知(Syntax-aware)”机制。通过先解析代码的抽象语法树(AST),再进行节点级的差异比对,工具能够天然过滤掉毫无意义的排版与换行干扰,将审查者的注意力重新聚焦于具体的表达式、逻辑语句和程序结构本身。
开源项目 OmniDiff 正是为此打造的内容感知(Content-aware)利器。它不仅在底层实现了精确到语法树级别的代码比对,更能智能解析图片、字体、PDF 及压缩包等非文本内容的差异。配合其现代化的交互式终端界面(TUI)以及与 Git / Jujutsu 的无缝集成,OmniDiff 极大地降低了甄别文件差异时的心智消耗,是构建极简、高效本地工作流的必备工具。
OmniDiff:https://github.com/ivankovic/omnidiff
OmniDiff 的口号是 Fast, robust, accurate content-aware diffing。它会先识别文件类型,再选择最合适的算法:
- 代码:使用 Tree-sitter 解析成 AST,进行结构级对比(支持 25 种语言 + 纯文本回退)。
- 图片:像素级比较。
- 字体 / 光标 / 消息目录 / 压缩包 / PDF:按内部结构(字形、页面、成员等)对比。
- 不支持的二进制:直接报告为二进制差异。
官方给出的基准(在 Intel Core i7-1370P + 32GB 内存上测得)非常亮眼:
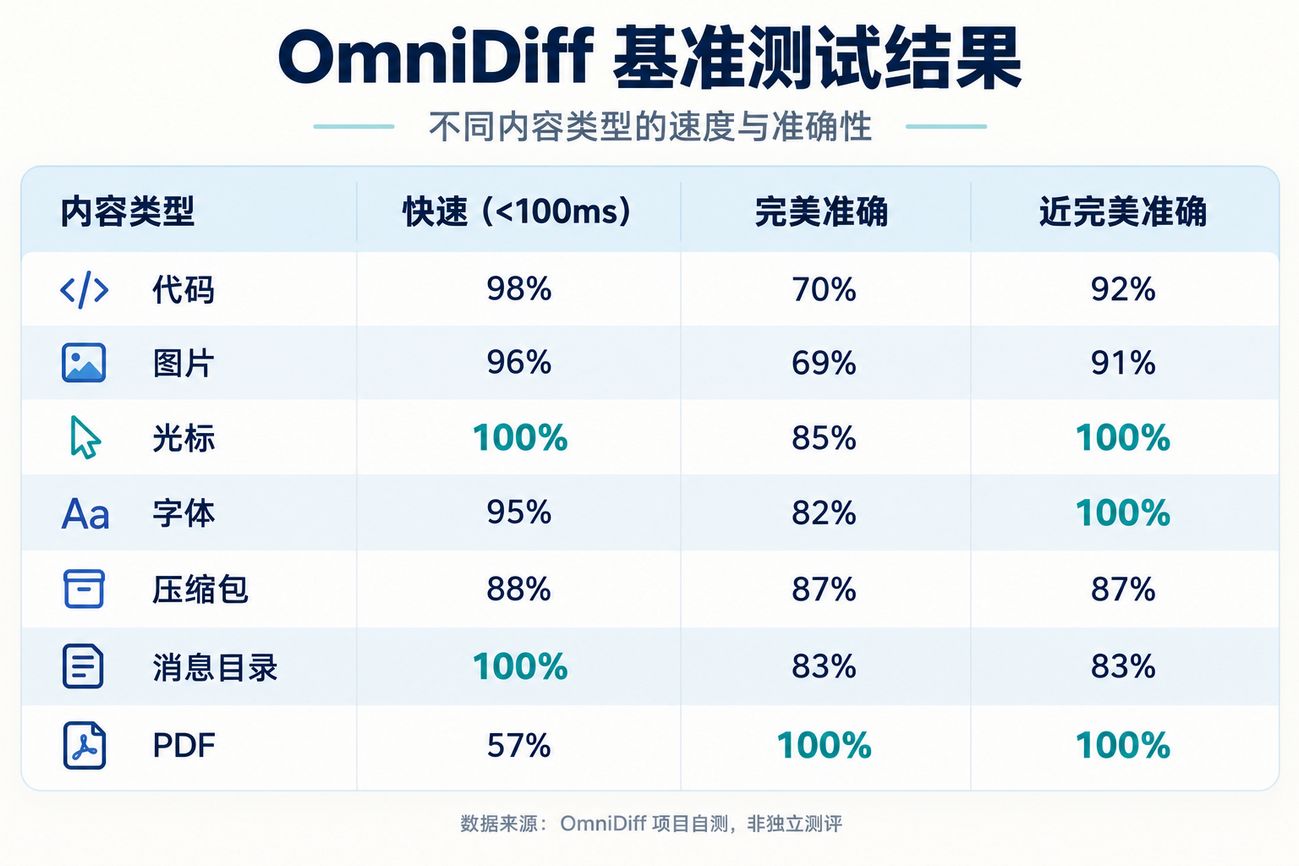
OmniDiff 最有价值的地方在于把“内容感知”从纯代码扩展到了更多文件类型对非代码内容的处理,是它与许多纯代码 diff 工具拉开区别的地方。
OmniDiff 的一些使用场景:
- 网站视觉检查:比较修改 CSS 前后的页面截图,排查意外的间距、图标或布局变化。
- 资源包更新检查:比较两份网站主题或插件压缩包,先定位发生变化的成员,再检查具体内容。
- 设计交付复核:比较两个版本的 PDF,确认需要调整的页面,同时检查是否误改了其他页面。
- 字体资源维护:更新图标字体时,检查变动是否集中在预期的字形。
类似 OmniDiff 工具可以大致分为三大类:语法树级 diff、 语义与实体级 diff、行 diff 的显示增强。
1. 语法树级 diff
语法树级 diff 解析后比较语法树
https://github.com/Wilfred/difftastic
https://github.com/afnanenayet/diffsitter
https://github.com/GumTreeDiff/gumtree
2. 语义与实体级 diff
语义与实体级 diff 关心“改动意味着什么”或“哪个函数变了”,而不是哪些字符变了。
https://semanticdiff.com/
https://github.com/Ataraxy-Labs/sem
3. 行 diff 的显示增强
https://github.com/dandavison/delta
日常使用推荐:
日常看 diff、追求速度与美观 → 先用 Delta 作为 pager。
需要同时处理代码 + 图片/字体/PDF 等富内容 → OmniDiff 目前最全面。
格式化/AI 重构产生大量噪声、需要看“真正改了什么” → OmniDiff 或 Difftastic 。
深度集成 GitHub PR 审查或 VS Code → 可考虑 SemanticDiff。